入門導讀: AI 晶片架構,GPU、TPU、Cerebras、Groq 各自怎麼解決搬資料的問題
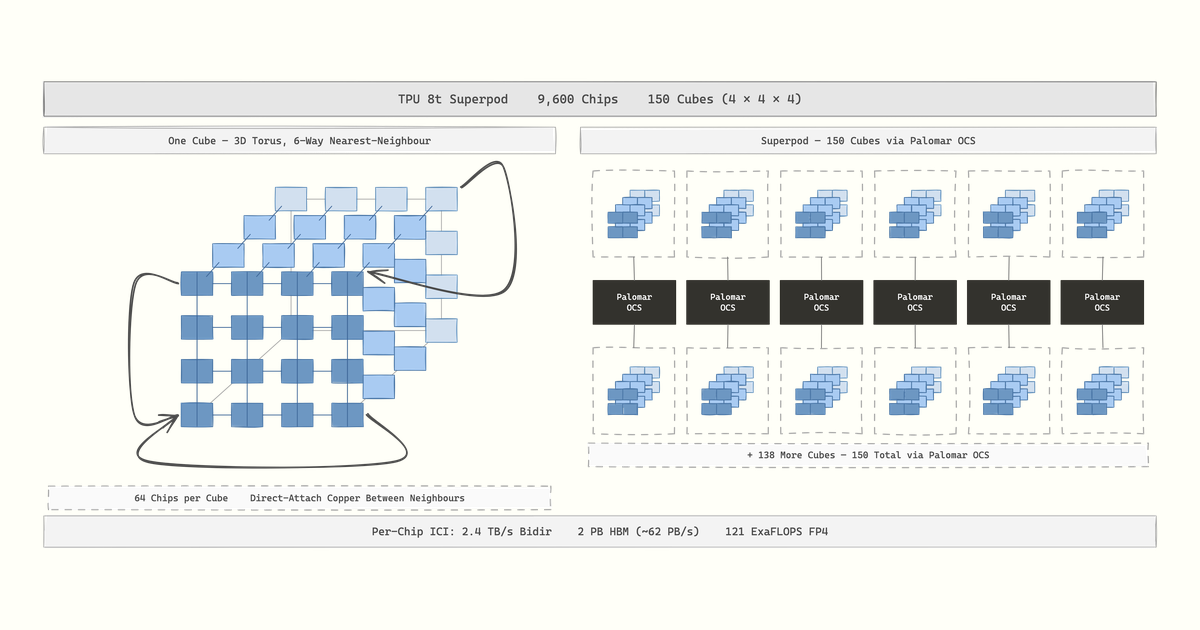
Jacob Peake 這篇〈AI Chip Architectures〉把目前有大規模部署的 AI 晶片拆開比較: NVIDIA GPU、Google TPU、AMD GPU、Cerebras、AWS Trainium、Groq。內容很完整,但寫給硬體背景的讀者,一般軟體工程師讀起來門檻很高。
小編把它整理成入門版,只留下跟「LLM 推論和部署」有關的部分。讀完你應該能回答這幾個問題:
- 為什麼 LLM 產生輸出的速度,常常卡在記憶體而不是算力?
- 為什麼推論服務一定要做 batching? 為什麼大家都在做 FP8、FP4 量化?
- 為什麼 Cerebras、Groq 可以每秒產生上千個 token,但價格比較貴?
先懂三個基本觀念
觀念 1: AI 運算幾乎都是矩陣乘法
Transformer 模型的每一層,主要就是拿輸入去乘上好幾個大型的權重矩陣,中間再穿插一些簡單運算 (例如 normalization、activation function)。原文提到,一個 transformer block 大約 99% 的運算量都是矩陣乘法。
矩陣乘法拆到最小,就是重複做「乘完再加」: c = c + a × b。所以 AI 晶片的設計目標很單純: 同時做越多次乘加越好。
觀念 2: 速度常常卡在「搬資料」,不是「算」
晶片的計算速度這些年進步很快,但從記憶體讀資料的速度進步慢很多,這個落差叫做「記憶體牆」(memory wall)。結果是運算單元常常閒著,在等資料送過來。
這件事在 LLM 推論特別明顯。LLM 回應一個請求分成兩個階段:
權重讀進來一次,可以拿去跟上千個 token 相乘
→ 計算量大,算力是瓶頸
→ 稱為「算力受限」(compute-bound)
每產生一個 token,都要把全部權重和 KV Cache 從記憶體讀一遍
→ 讀了一大堆資料,只做一點點計算
→ 稱為「記憶體受限」(memory-bound)
用數字感受一下 (以下是小編的粗估): 一個 70B 參數的模型用 FP16 存,權重大約 140 GB。放在一顆 NVIDIA B200 上 (記憶體 192 GB、頻寬 8 TB/s),光是把權重讀一遍就要約 17.5 毫秒,所以只服務一個使用者時,每秒最多大約 57 個 token。而且這還沒算讀 KV Cache 的時間。這個上限跟晶片算力多強無關,取決於記憶體頻寬。
NVIDIA 官方文件〈GPU Performance Background User’s Guide〉也有類似的例子: 在 V100 上,同一個全連接層,batch size 512 時每讀 1 byte 可以做 315 次運算 (算力受限),batch size 1 時只能做 1 次 (記憶體受限)。
觀念 3: 推論優化的核心,就是「讀一次資料,做更多事」
理解觀念 2 之後,很多常見的推論優化技巧就說得通了:
- Batching: 把很多使用者的 decode 合在一起算。權重讀一次,可以同時幫 64 個使用者各產生一個 token。這跟資料庫「一次批次查詢比 N 次單筆查詢有效率」是同樣的道理
- Speculative decoding: 先快速猜出幾個 token,再讓大模型一次驗證,等於讀一次權重處理好幾個 token
- 量化 (FP8、FP4): 權重從 16 bit 變成 8 bit 或 4 bit,要讀的資料量就減半或剩四分之一
不過原文也提醒一個限制: batching 只能讓大家共用「權重」這份資料,每個使用者的 KV Cache 還是要各自讀。所以上下文很長的時候,瓶頸會從讀權重變成讀 KV Cache。
再補幾個硬體名詞
放在晶片旁邊的高頻寬記憶體。容量大 (幾十到幾百 GB),GPU 和 TPU 的模型權重通常放這裡
直接做在晶片裡。速度比 HBM 快很多,但很佔晶片面積,所以容量小 (通常只有 MB 等級)
把幾顆到幾十顆晶片用專用高速線路綁在一起 (例如同一個機櫃),讓它們幾乎可以當成一顆大晶片用
再用資料中心網路把很多個 scale-up 單位串起來。規模可以很大,但速度比 scale-up 慢一個數量級
Scale-up 和 scale-out 的差別,跟部署大模型直接相關: 一個模型如果大到要切給多顆晶片一起算 (例如 tensor parallelism),這些晶片之間要頻繁交換資料,最好放在同一個 scale-up 單位裡。
六種 AI 晶片
1. NVIDIA GPU: 什麼都能跑的通用平行處理器
NVIDIA 的路線是做一顆「可以寫程式做任何平行運算」的晶片。同一顆 GPU 可以訓練模型、跑推論、算圖形、做科學模擬。
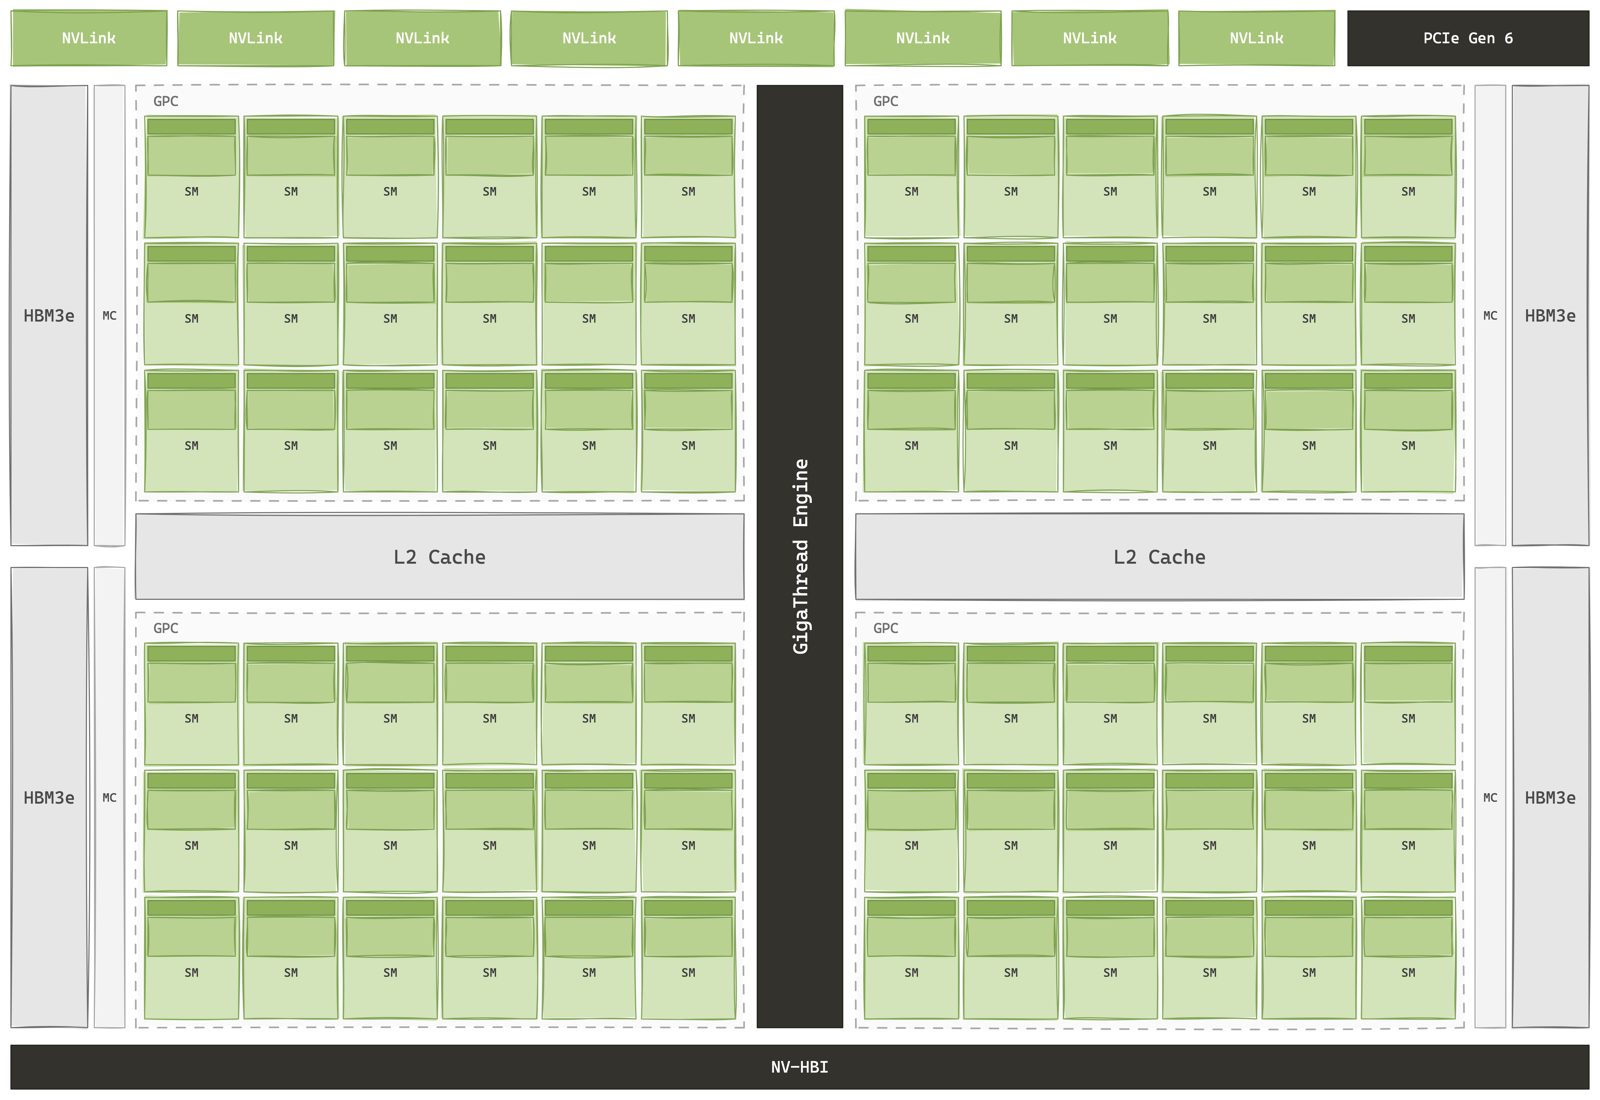
B200 這類 GPU 的示意圖: 中間綠色的小方塊都是一個個運算核心 (SM),左右兩側是 HBM。圖片來源: Jacob Peake
怎麼做: 一顆 GPU 裡有上百個運算核心 (稱為 SM,H100 有 132 個、B200 有 148 個),每個核心裡有專門做矩陣乘法的 Tensor Core。GPU 同時跑非常多的執行緒,某一批在等記憶體時,硬體就切換去跑另一批,用「同時有很多工作」來掩蓋等待時間。這跟作業系統在某個執行緒等 I/O 時切去跑別的執行緒是同樣的思路。
近幾代 GPU 還讓矩陣乘法可以「在背景執行」,同時去做 softmax 等其他運算,有點像從同步呼叫改成 async。目前最快的 attention 實作 FlashAttention-3、FlashAttention-4,就是靠這種重疊來提升速度。
部署上的重點: GB200 NVL72 把 72 顆 GPU 放進一個機櫃,彼此可以直接讀寫對方的記憶體,對軟體來說像一個超大的 GPU。大模型切給多顆 GPU 時,只要在這 72 顆以內,溝通就很快;跨機櫃就要走網路,頻寬少一個數量級。
軟體: NVIDIA 最大的優勢在軟體生態。CUDA 從 2007 年到現在,程式設計方式幾乎沒變,上面累積了大量函式庫 (cuBLAS、TensorRT-LLM 等) 和第三方 kernel。原文的觀察是,這些大多數不是 NVIDIA 付錢請人寫的,而是二十年來數百萬開發者累積的。新的模型架構或優化技巧,通常也最先在 NVIDIA 上跑得好。
2. Google TPU: 只專心做矩陣乘法,一切交給編譯器事先排好
TPU 走另一個極端: 不追求通用,只把矩陣乘法做到最有效率。
怎麼做: TPU 的核心是一個 256×256 的「脈動陣列」(systolic array)。運作方式如下:
資料一旦進入陣列,就在格子之間直接傳遞,不用再讀記憶體。為什麼要這麼做? 原文給了一個關鍵數字: 讀寫一次記憶體的耗電,是做一次乘法的 100 到 1000 倍。
另一個特色是「編譯器事先排好一切」。GPU 是執行時由硬體動態決定接下來做什麼;TPU 則是由 XLA 編譯器在編譯時就決定好每一步要算什麼、資料放哪裡、什麼時候搬。好處是晶片不需要放複雜的排程硬體,面積都拿去做運算;壞處是編譯器排錯了,執行時也沒有任何補救機制。
部署上的重點:
- 矩陣大小最好是 128 或 256 的倍數。原文舉例: 在 256×256 的陣列上算 128×128 的矩陣,75% 的運算單元會閒置
- TPU 可以串成非常大的規模: Ironwood (TPU v7) 一組可以有 9,216 顆晶片,NVIDIA NVL72 是 72 顆
- Google 在 2026 年推出推論專用的 TPU 8i,把晶片內記憶體加大到 384 MiB,目的是讓 KV Cache 可以整個放在晶片上。網路拓撲也重新設計,因為 MoE 模型需要每顆晶片跟所有其他晶片交換資料
軟體: 主要用 JAX 寫,PyTorch 支援一直比較弱,Google 在 2026 年 4 月宣布 TorchTPU 來改善。vLLM 在 TPU 上也是把模型統一轉成 JAX 來執行。
3. AMD GPU: 跟 NVIDIA 類似,主打記憶體容量
AMD 的 GPU 跟 NVIDIA 是同一類設計,名詞也大致對得上 (Compute Unit 對應 SM、Matrix Core 對應 Tensor Core、ROCm 對應 CUDA)。差別在於 AMD 把資源集中在記憶體容量和封裝技術。
記憶體容量是 AMD 的強項: HBM 容量從 2021 年起每一代都追平或超過同期 NVIDIA 旗艦,MI300X 192 GB、MI325X 256 GB、MI355X 288 GB。原文舉了一個部署上的例子: 8 顆 MI300X 共有 1.5 TB 記憶體,一個 405B 參數的模型用 FP8 存,可以直接放進一台 8 卡伺服器;同樣的模型放在 8 顆 H100 (共 640 GB) 上就得小心切分。
弱點:
- 機櫃級的 scale-up 來得晚: 到 MI355X 為止,AMD 的 scale-up 只有一台 8 卡伺服器,沒有對應 NVL72 的方案。2026 下半年的 Helios (72 顆 MI455X) 才補上
- 軟體還有差距: 原文引用 Phoronix 2026 年 3 月的測試,ROCm 7.2 在 PyTorch、vLLM、SGLang 這些常見工作負載上,比同等級的 CUDA 慢 10–25%。最新的 FlashAttention-4 也還沒有 ROCm 版本
- 矩陣運算不能在背景執行: NVIDIA 那種「矩陣乘法在背景跑、同時做 softmax」的硬體支援 AMD 沒有跟進,attention 這類 kernel 要靠軟體手動安排
AMD 的軟體策略是走開源和 Triton: PyTorch 的 torch.compile 透過 Triton 產生 kernel,同一份程式碼在 NVIDIA 和 AMD 上都能跑。實際部署也已經有大型案例: 原文提到 OpenAI 在 Azure 的 MI300X 上跑 GPT 推論,Meta 用 MI300X 跑 Llama 推論,vLLM 的 ROCm 測試通過率在 2026 年初從 37% 提升到 93%。
4. Cerebras: 一整片晶圓做成一顆晶片
一般晶片的做法,是在一片晶圓上印出幾十顆晶片再切開,單顆晶片的大小有製程上限 (約 850 mm²)。切開之後,業界再花大量工夫用 HBM、高速線路把晶片接回去,但這些連線的速度遠不如晶片內部。
Cerebras 的做法是不切。WSE-3 是一整片晶圓: 46,225 mm²、90 萬個小核心、44 GB SRAM,完全沒有 HBM。
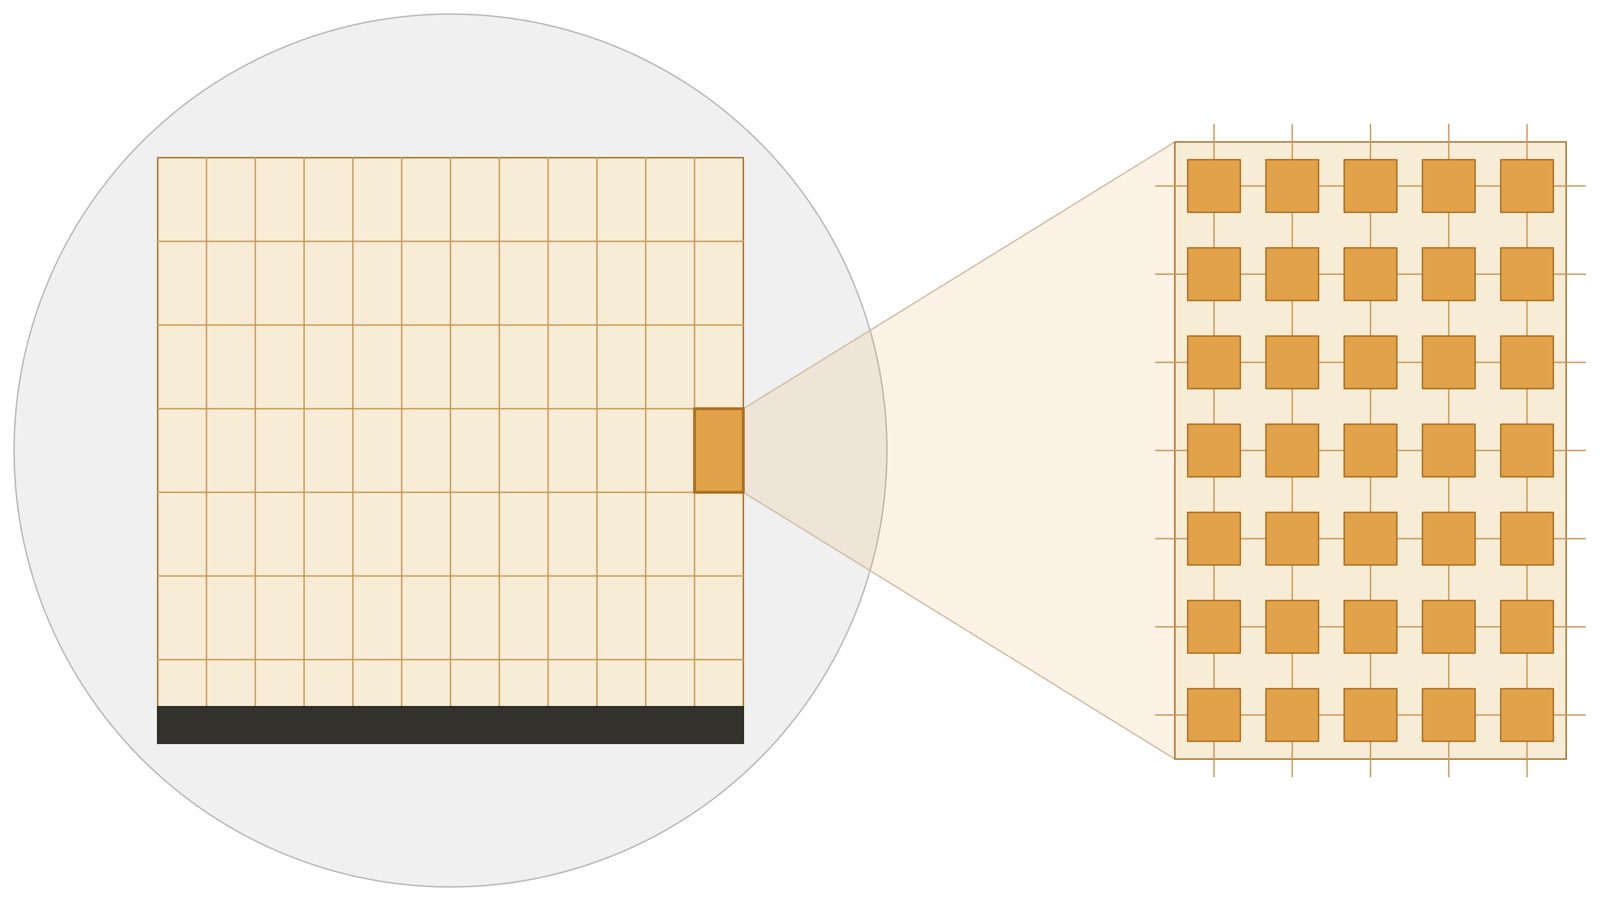
整片晶圓上的晶粒全部連在一起不切開,每個晶粒裡是大量小核心組成的網格。圖片來源: Jacob Peake
為什麼推論特別快: 回想觀念 2,decode 的瓶頸是讀記憶體。WSE-3 的 44 GB 全部是晶片內的 SRAM,總頻寬 21 PB/s,是 B200 HBM 的兩千多倍 (不過這是 90 萬個核心各自頻寬的加總,不能完全直接比較)。原文用「每次運算能分到多少 byte 資料」來比較: WSE 約 1.3 bytes,B200 只有約 0.002。
實測數據也證明了這點: Artificial Analysis 在 2024 年量到 Llama 3.1 70B 每秒 446 個 token、8B 每秒 1,850 個 token,2025 年 Llama 4 Maverick 每秒 2,522 個 token。對照前面小編粗估的單顆 B200 單一使用者約每秒 57 個 token,差距很明顯。原文也提到 OpenAI 在 2026 年 1 月簽下 750 MW 的 Cerebras 算力合約。
代價:
- 44 GB 放不下大模型: Llama 70B 至少要 4 台 CS-3 系統,更大的模型要更多台
- 價格較高: 原文整理的數據是 API 每 token 價格大約是 GPU 供應商的 3–5 倍
- 上下文長度受限: KV Cache 跟權重共用同一份 SRAM,API 上限是 131K token
- 沒有低精度格式: 浮點運算只到 16-bit,沒有 FP8、FP4,無法靠量化減少需要的系統數量
- 軟體彈性低: 只支援靜態運算圖,PyTorch 流程裡使用者不能自己寫 kernel,遇到不支援的運算要靠 Cerebras 工程師處理
5. AWS Trainium: 參考 TPU 的設計,只在 AWS 上提供
Trainium 由 AWS 旗下的 Annapurna Labs 設計。原文的定位是「快速跟進者」: 核心設計參考 TPU 已經驗證過的做法 (128×128 脈動陣列、編譯器事先排程),甚至共用 Google 開源的 XLA 編譯器。
商業邏輯不同: Trainium 只在 AWS 雲端上提供,只需要在 AWS 內部提供比 NVIDIA 更好的性價比。AWS 宣稱 Trainium2 比 Hopper 等級的 GPU 執行個體性價比好 30–40% (這是 AWS 自己的數字,比較對象是上一代 NVIDIA)。最大的客戶是 Anthropic: Project Rainier 約 50 萬顆 Trainium2,到 2026 年初 Claude 已經跑在超過 100 萬顆 Trainium 晶片上。
部署上要注意的:
- 看規格要小心: Trainium3 支援 FP4,但 FP4 資料會先轉成 FP8 再計算,所以只省記憶體和頻寬,計算速度跟 FP8 一樣
- 移植到 Trainium 的模型只能在 AWS 上跑,沒有其他廠商可以替換
- 軟體生態還年輕。原文指出,連 Anthropic 都是自己用 NKI (Trainium 的 kernel 語言) 寫底層 kernel,並跟 Annapurna 團隊密切合作
6. Groq LPU: 每個步驟都在編譯時排好的推論晶片
Groq 的創辦人 Jonathan Ross 當年在 Google 發起了 TPU 專案。LPU 把 TPU「讓編譯器排程」的想法做到最徹底: 晶片上沒有 cache、沒有任何動態排程的硬體,編譯器事先決定每個資料在哪個時脈週期出現在哪裡,連多顆晶片之間的資料傳輸也排好。所以執行前就能精確知道要花多少時間。
記憶體只有 SRAM,而且很小: 每顆晶片只有 230 MB SRAM,沒有 HBM。一個 FP16 的 Llama-2 70B 有 140 GB,要分散在約 576 顆晶片上才放得下。需要多少晶片是由「放不放得下權重」決定,不是由算力決定。
取捨: 跟 Cerebras 一樣,LPU 擅長的是「單一使用者的產生速度」,也就是 batch size 1 的情境,這正好是 GPU 最弱的地方。但原文引用 SemiAnalysis 的分析: 一旦開始做 batching 追求總吞吐量,每塊錢能處理的 token 數大約只有 GPU 的十分之一。
後續發展: 2025 年 12 月 NVIDIA 取得 Groq 的技術授權,並延攬了 Ross 和大部分團隊。2026 年 GTC 推出 NVIDIA Groq 3 LPU,跟 NVIDIA 的 GPU 機櫃搭配使用: GPU 負責 attention,LPU 負責 FFN 和 MoE 層。
整體比較
把六種晶片放在一起,可以從「通用」排到「專用」:
執行時由硬體排程
權重放 HBM
什麼都能跑,軟體生態最成熟
編譯時事先排程
權重放 HBM
只在自家雲端提供
一整片晶圓
權重全放 SRAM
單一使用者速度快、價格高
連晶片間傳輸都事先排程
權重全放 SRAM
單一使用者速度快、價格高
✏️ 小編製圖
單顆晶片的記憶體和算力差異很大 (記憶體數字取自原文比較表,算力以各家官方規格為準,都是不含稀疏運算的密集算力):
| 晶片 | 記憶體容量 | 記憶體頻寬 | FP16 算力 | FP8 算力 |
|---|---|---|---|---|
| NVIDIA B200 | 192 GB HBM | 8 TB/s | 2.25 PFLOPS | 4.5 PFLOPS |
| Google Ironwood (TPU v7) | 192 GB HBM | 7.4 TB/s | 2.3 PFLOPS | 4.6 PFLOPS |
| AMD MI355X | 288 GB HBM | 8 TB/s | 2.5 PFLOPS | 5 PFLOPS |
| AWS Trainium2 | 96 GB HBM | 2.9 TB/s | 0.67 PFLOPS | 1.3 PFLOPS |
| Cerebras WSE-3 | 44 GB SRAM | 21 PB/s (晶圓內加總) | 約 15.8 PFLOPS* | 不支援 |
| Groq 第一代 LPU | 230 MB SRAM | 80 TB/s (晶片內加總) | 0.188 PFLOPS | 不支援 |
* Cerebras 官方只公布含稀疏運算的 125 PFLOPS,這是原文用核心數 × 每核心運算寬度 × 時脈推算的密集算力。原文表格的 MI355X FP8 寫 10 PFLOPS,那是含稀疏運算的數字,AMD 官方的密集 FP8 是 5 PFLOPS,本表以官方為準。
可以看到兩種路線: 用 HBM 的晶片容量大、頻寬相對低,一顆就放得下大模型;只用 SRAM 的晶片頻寬極高、容量很小,要很多顆才放得下一個模型。
算力欄位有幾個值得注意的地方。第一,B200、Ironwood、MI355X 的算力非常接近 (FP8 都在 4.5 到 5 PFLOPS 之間),原文的看法是單顆晶片的算力競賽已經差不多,各家真正拉開差距的是多顆晶片怎麼串接,以及軟體生態。第二,用 FP16 比較的話,Cerebras 的算力最高 (畢竟是一整片晶圓),但它和 Groq 不支援 FP8,賣點也不在算力,而在記憶體頻寬。第三,同一顆晶片的 FP8 算力大約是 FP16 的 2 倍: 位元數減半,同樣的晶片面積可以多做一倍運算。這也是量化除了減少要讀的資料量之外,還能提升算力的原因。
延伸: AI 公司開始自己做晶片
原文沒有談到的一個趨勢是,OpenAI 和 Anthropic 這些模型公司也開始自己設計晶片了。
OpenAI Jalapeño: 用 HBM 做到接近 SRAM 晶片的速度
OpenAI 在 2026 年 6 月發表第一顆自研推論晶片 Jalapeño,跟 Broadcom 合作開發,預計 2026 年底開始部署 (出處: OpenAI)。規格是 216 GiB HBM4、15.4 TB/s 頻寬、700 W,單看數字並不突出,但 8 月在 Hot Chips 2026 公開的設計思路,正好呼應本文的幾個觀念:
頻寬夠,但用不到: OpenAI 算過,128 顆 Jalapeño 的 HBM 總頻寬超過 1 PB/s,只看頻寬的話,每位使用者每秒應該能產生 1,000 到 2,000 個 token,但實際系統遠低於此,因為運算單元有很多時間在等資料傳遞。所以 Jalapeño 把晶片切成 64 個核心區塊,每塊配一份自己的 HBM,常用資料就在旁邊 (出處: ServeTheHome、Tom’s Hardware)。OpenAI 表示 GPT-OSS 因此能做到每位使用者每秒接近 1,500 個 token,「這以前是 SRAM 晶片的領域」(出處: Tae Kim 的演講整理)。也就是說,速度快不一定要像 Cerebras、Groq 一樣只用 SRAM。
一顆晶片處理整個請求: prefill、speculative decoding 的草稿、大模型驗證三個階段的瓶頸各不相同。OpenAI 沒有像 NVIDIA 搭配 Groq LPU 那樣分給不同晶片,而是用一顆晶片全包,好處是 KV Cache 不用在晶片之間搬來搬去 (出處: ServeTheHome)。
效能數字要看前提: OpenAI 宣稱比 NVIDIA GB200、GB300 每瓩吞吐量好 1.5 到 1.9 倍,但沒有跟新一代 Rubin 比,功耗用官方標示上限換算,而且是 OpenAI 自己公布的數字 (出處: Tom’s Hardware)。
Anthropic: 正在組團隊
Anthropic 在 2026 年 8 月證實正在組自研晶片團隊,說法是要「一起設計硬體和模型」,讓 Claude 跑得更快更有效率,同時會繼續採用多家廠商的晶片。目前還沒有公開任何架構資訊 (出處: Business Insider)。
多平台的代價
不管有沒有自研晶片,兩家公司都同時用好幾種晶片。Claude 跑在 Trainium、NVIDIA GPU、TPU 三種平台上;OpenAI 除了 NVIDIA,也用 AMD MI300X 跑推論、用 Cerebras 提供高速推論,另外還簽了 AMD MI450 和 2 GW Trainium 的算力合約 (出處: OpenAI、Amazon)。好處是能取得足夠的算力,代價是開發難度增加: 每種平台要各自最佳化,還要確保使用者不管被分到哪個平台,回答品質都一樣。
Anthropic 公開過一個實際案例。2025 年 8 月起,陸續有使用者反映 Claude 的回答品質時好時壞。Anthropic 調查後在 9 月發表〈事後檢討〉,說明品質下降是三個基礎設施 bug 同時發生造成的,並特別澄清從來不會因為需求量或伺服器負載而降低模型品質。三個 bug 裡有兩個只發生在 TPU 上,其中一個是這樣: 模型用 bf16 算 token 機率,但 TPU 的 XLA 編譯器會自動把部分運算改用 fp32,導致不同運算對「哪個 token 機率最高」判斷不一致,最可能的 token 偶爾會被漏掉。這種問題只出現在特定平台上,很難察覺。OpenAI 沒有公開類似的案例,但只要同時維護多種晶片,就得面對同樣的驗證成本。自研晶片上線之後,要維護的平台又多一種。
對軟體工程師的意義
以下是小編延伸整理的,原文沒有直接寫:
1️⃣ 推論慢的時候,先想是不是卡在記憶體。Decode 階段幾乎都受限於記憶體,有效的優化都是在「少讀一點資料」或「讀一次資料做更多事」: 量化、batching、speculative decoding、縮小 KV Cache。
2️⃣ 「速度快」和「價格便宜」的推論服務,背後是不同的硬體取捨。Cerebras、Groq 單一使用者的速度最快,但成本高、上下文長度也有限制;GPU 靠大 batch 提高總吞吐量,單一使用者比較慢但便宜。選 API 供應商時,可以看應用是在乎延遲 (即時語音、互動式 coding agent) 還是在乎成本 (批次處理大量文件)。
3️⃣ 自己部署模型時,先算記憶體放不放得下。模型權重加上 KV Cache 能不能放進一台伺服器,決定了要不要跨伺服器切分。這也是 AMD 主打記憶體容量的原因。
4️⃣ 想保留換硬體的彈性,就不要直接寫 CUDA。用 PyTorch + torch.compile 或 JAX 這類中間層,比較容易在 NVIDIA、AMD、TPU 之間移植。不過最新的優化技巧通常還是先出現在 NVIDIA 上,而且換平台後要重新驗證輸出,前面「多平台的代價」的例子就說明了程式碼能跑不代表結果一樣。
結語
這篇文章最值得帶走的觀念是: 每一種 AI 晶片,都是對同一個問題 (資料搬得不夠快) 的不同解法。NVIDIA 用大量執行緒和背景執行來掩蓋等待時間,TPU 和 Trainium 讓資料在陣列裡重複使用、由編譯器事先排好,AMD 用更大的記憶體容量,Cerebras 和 Groq 乾脆把權重全部放進晶片內的 SRAM。
每種做法都有代價,沒有一種在所有情境都最好。NVIDIA 把 Groq 的技術拿來搭配自家 GPU,讓 GPU 算 attention、LPU 算 FFN,也說明未來的推論系統可能會混用不同架構,依工作類型分配給最適合的硬體。
原文還有很多本文略過的硬體細節 (各代晶片演進、晶片內部結構、網路架構),有興趣深入的話很值得讀完。
參考連結
- Jacob Peake〈AI Chip Architectures〉: 本文主要來源,六種架構的設計理念、記憶體、多晶片串接、軟體,以及比較表數據
- NVIDIA〈GPU Performance Background User’s Guide〉: V100 上全連接層 batch size 1 vs 512 的運算強度範例
- 比較表算力數字的官方規格: NVIDIA HGX B200 (8 顆 GPU 合計、含稀疏運算的數字,本文換算成單顆密集算力)、Google Cloud TPU7x (Ironwood)、AMD Instinct MI355X、AWS Trainium2
- OpenAI〈OpenAI and Broadcom unveil LLM-optimized inference chip〉: Jalapeño 官方發表,部署時程
- ServeTheHome〈OpenAI Jalapeno Custom AI ASIC at Hot Chips 2026〉: Hot Chips 演講現場整理,頻寬上限 vs 實際速度、單一晶片處理整個請求
- Tom’s Hardware〈Hot Chips 2026: OpenAI’s Jalapeño AI ASIC unpacked〉: 規格、64 個核心區塊各配一份 HBM 的架構
- Tom’s Hardware〈OpenAI’s 700W Jalapeño ASIC outpaces 1,400W Nvidia flagship GPU〉: 效能比較數據與測試前提
- Tae Kim〈Hot Chips: OpenAI Jalapeno Presentation〉: 演講引述,GPT-OSS 每位使用者每秒近 1,500 token
- OpenAI〈AMD and OpenAI announce strategic partnership to deploy 6 gigawatts of AMD GPUs〉: OpenAI 的 AMD GPU 合約
- Amazon〈OpenAI and Amazon announce strategic partnership〉: OpenAI 使用 2 GW Trainium 算力
- Business Insider〈It’s official: Anthropic is building an in-house chip team for Claude〉: Anthropic 證實組自研晶片團隊
- Anthropic〈A postmortem of three recent issues〉: Claude 在 Trainium、GPU、TPU 多平台部署,以及 TPU 上的數值精度 bug