寫程式變強,寫作卻沒跟上: AI 能力會全面進步,還是越來越不平均?
7 月底劍橋大學研究者 Adam Hunt 在 X 上發了一篇長文,開頭就說: 最近他對 AI 從看多轉成看空 (出處: Adam Hunt)。這篇貼文到現在累積超過 100 萬次瀏覽、250 多則引用轉推,The Decoder 也把它跟一位 OpenAI 研究員的離職聲明放在一起報導 (出處: The Decoder)。
Adam 不是 AI 研究者,他的專業是演化精神醫學,研究的是神經多樣性 (neurodiversity): 每個人的能力本來就有強有弱,分布並不平均。也許正因為如此,他特別注意到模型「哪些能力變強、哪些沒變」。
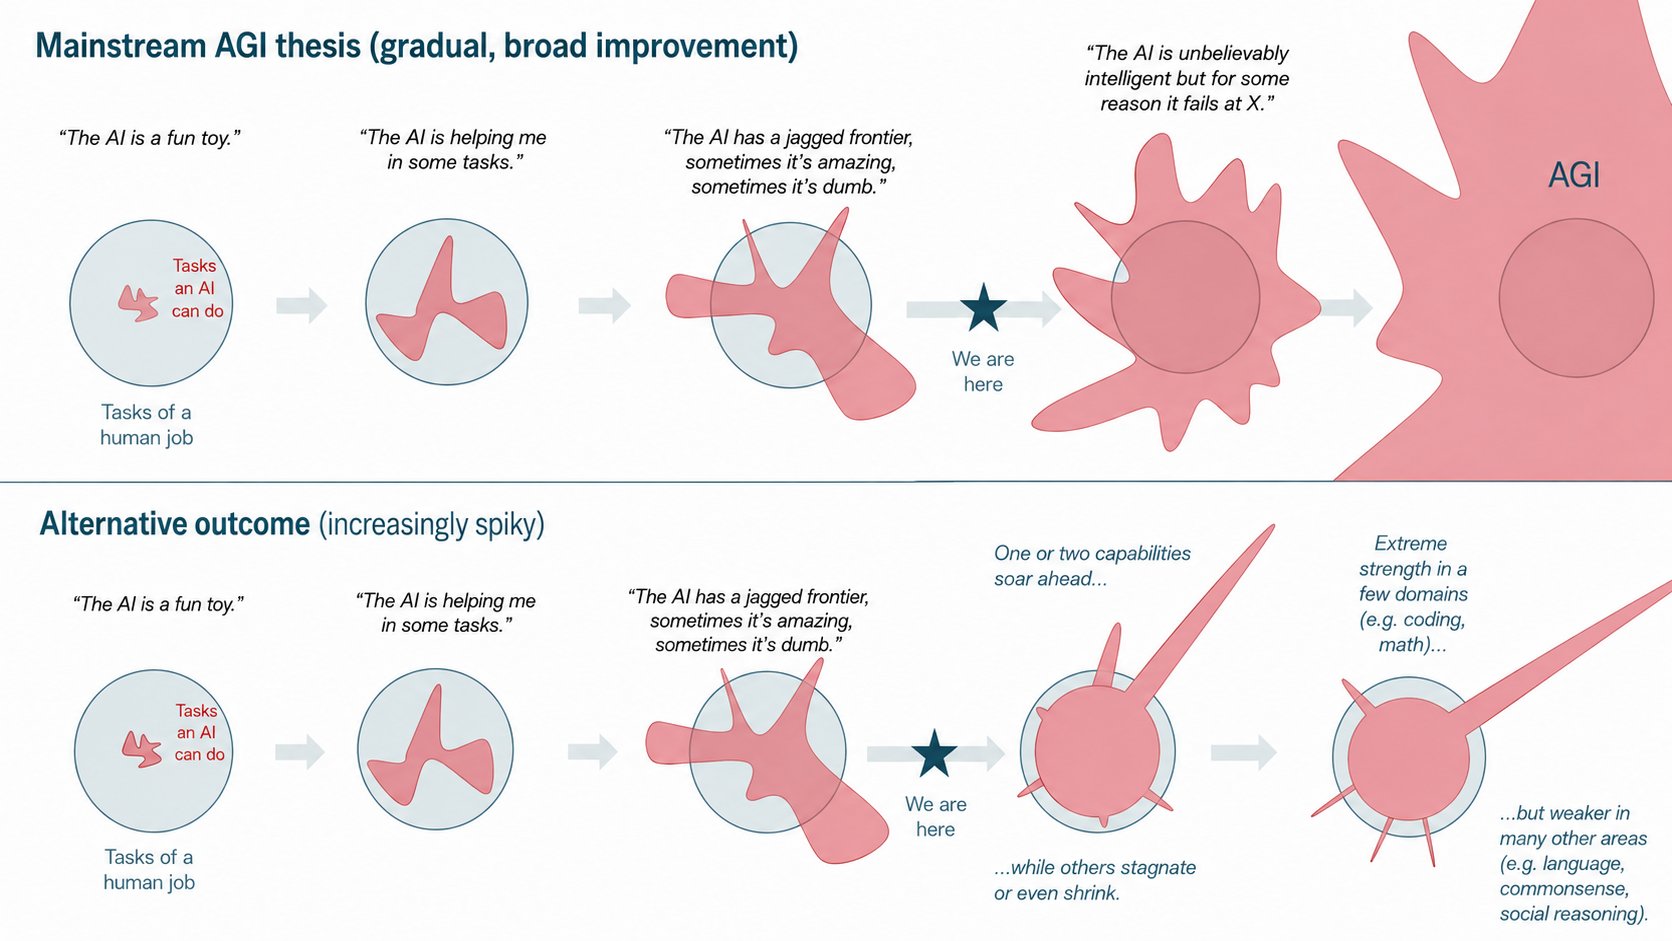
小編先用 Adam 附的那張圖 (也就是本文封面) 說明他的主張,再整理他的論證、回覆串裡的補充,以及這兩個多月來的後續討論。
1. 先看懂這張圖: AI 能力的兩種發展路線
Adam 貼文附的這張圖是整個討論的起點。圖的上半對應 Tomas Pueyo 在 2025 年 11 月畫的 AGI 論述圖,當時流傳很廣; 下半是另一種可能,也就是 Adam 認為正在發生的情況。小編把它重新畫成兩張圖,一步一步說明。
先講圖的讀法: 虛線圓圈代表一份人類工作包含的所有任務,紅色形狀代表 AI 做得到的任務。紅色超出圓圈的部分,代表 AI 在這些任務上已經超越人類; 圓圈裡沒被紅色蓋到的地方,代表 AI 還做不好的任務。
前三個階段: 兩種說法都同意
- 一開始,AI 只做得到工作中很小的一塊,大家把它當成好玩的玩具。
- 能做的範圍變大,開始能幫忙處理部分工作,但每一項都還在圓圈內,也就是還不如人。
- 現在的狀態: 有幾根尖刺超出圓圈,在寫程式、數學等任務上超越人類; 但其他方向還在圓圈內,有些很基本的事也會出錯。這就是常說的「參差不齊的能力邊界」(jagged frontier): 同一個模型,有時表現很好,有時又在簡單的事上犯錯。
到這裡兩種說法沒有分歧,差別在於從第 3 階段之後會怎麼發展。
第 4、5 階段: 兩種說法開始不同
路線一 (主流 AGI 論述): 隨著模型擴展,各個方向會一起變大。到第 4 階段,紅色已經蓋住圓圈的大部分,只剩少數缺口,使用者的感受會變成「AI 聰明得不可思議,但不知為何就是做不好某件事」。到第 5 階段,整個圓圈都被蓋住,所有任務都超越人類,這就是 AGI。
路線二 (Adam 認為正在發生的): 只有少數幾根尖刺持續變長,其他方向停滯,甚至縮小。到第 5 階段,模型在寫程式、數學這類領域遠遠超過人類,但在語言、常識、社交推理等領域反而比以前弱,圓圈大部分還是沒被蓋住。
兩條路線的關鍵差別,在於尖刺之間的空隙會不會被補滿。路線一假設某個領域的進步會帶動其他領域; 路線二則認為每根尖刺是各自變長的,一個領域的進步不會自動擴散到其他領域。Adam 認為最近幾代模型的表現比較像路線二,下一節是他的理由。
2. 他的論證: 早期 LLM 看起來通用,是因為預訓練語料本身就通用
Adam 的推論鏈大致是這樣:
- 早期的進步是預訓練語料帶來的。 網路上的文字涵蓋各種主題,模型越會模仿這份語料,看起來就越像「通用智慧」。但語言背後的邏輯和事實並沒有被有效學進去,所以進步到某個程度就停了。他認為時間點大約是 2024 年底,也就是大家在討論「擴展是不是撞牆了」的時候。
- 之後的突破來自 Chain of Thought 和網路搜尋。 這兩者讓模型更能發揮原本從語料學到的能力,帶來了 2024 年之後的進步。
- RL 只在可驗證的領域有效。 在一個領域上不斷做 RL,不能期待其他領域也跟著變好。
- 寫程式剛好最適合 RL,又最賺錢。 軟體工程師的工作幾乎完整記錄在程式碼和版本紀錄裡,可以當訓練資料,也容易設計明確的 benchmark 和獎勵。所以各家 AI 公司都往這裡集中,代價是一般寫作的品質下降。
他的結論是: 這條路仍然可能做出非常強大 (在資安上甚至危險) 的模型,但不是通往 AGI 的路。他也預測,如果他是對的,一兩年內從新模型的能力分布就會看出來。業界接下來可能會針對健康、法律等特定領域另外做 RL,再把多個專門模型串起來使用。
不過 Adam 自己只給這個判斷 40% 的信心,因為它沒有把可能出現的技術突破算進去。有人問他有沒有數據支持「除了寫程式以外都沒進步」,他直接承認主要是「感覺,加上跟其他重度使用者的討論」。他的理由是現有的指標一公布就會被各家拿去針對最佳化,指標本身就不準了,也就是古德哈特定律 (Goodhart’s law) 說的現象 (出處: Adam Hunt 回覆)。
3. 最直接的證據: 模型解釋自己做了什麼,越來越難懂
Adam 拿來當主要證據的,是語言輸出的品質。他的說法是: 如果模型真的變得更通用,它描述自己工作的文字應該越來越流暢、完整,但實際上跟 o3 比反而變差了。
在回覆串裡,他講得更具體:
- Opus 5 「幾乎看不懂」,花十分鐘做完事情後,用一堆奇怪的術語解釋自己做了什麼,以前不是這樣 (出處: Adam Hunt 回覆)。
- 最強的模型犯錯的次數其實差不多,但錯誤藏在一層層資料夾、難以理解的決策和不清楚的說明裡,反而更難發現,除錯也更花時間。他說這次的經驗正是他寫這篇貼文的起因 (出處: Adam Hunt 回覆)。
- 8 月底他又補了一句: Opus 4.6 寫作比較好,後面的版本「被 RL 往寫程式的方向推到其他都不顧了」(出處: Adam Hunt 回覆)。
小編覺得第二點對工程師最有感。模型產出的程式碼越來越多、越來越複雜,如果它的說明讓人看不懂,人工 review 的成本就會上升,錯誤也更容易被放過。所以這不只是文筆好不好的問題,而是會直接影響開發品質。
另外要注意一個背景: Adam 的工作跟生物醫學相關,他說自己很少能用到 Fable,因為他的請求常常被安全機制擋下或轉給其他模型 (出處: Adam Hunt 回覆)。他的觀察主要來自網頁版 Claude 和 ChatGPT,不是最強模型的全貌。
4. 回覆串裡的幾個延伸觀點
這篇貼文底下有 400 多則回覆,Adam 回了不少,其中幾則把他的論點補得更完整:
Chain of Thought 只是放大既有的能力。 Noah Smith 問: Chain of Thought 會讓模型更通用、更不通用,還是沒差? 畢竟推論算力還有很大的擴展空間 (出處: Noah Smith)。Adam 的回答是,Chain of Thought 是讓模型反覆運用自己已有的能力,所以本來就擅長寫程式,就會寫得更好; 但在模型本來就不擅長的科學推理上,它會不斷替自己的錯誤找理由,越想越偏。他舉的例子是 Opus 5 無法判斷某一篇 ADHD 藥物研究的結果該有多少參考價值 (出處: Adam Hunt 回覆)。
人本來也很偏科,但 AGI 論述不是這樣說的。 有人問: 很多聰明人也講不清楚話,憑什麼用文筆判斷通用能力? Adam 同意人的能力也很不均,這正是他的研究主題,可能也是他會注意到 AI 這個現象的原因。但 AGI 論述說的是,模型一旦超出那個圓圈,就會在各方面都超過人類,也就是既像 George Hotz 一樣會寫程式,又像 Stephen King 一樣會寫作,而這並沒有發生 (出處: Adam Hunt 回覆)。
「看空」是指 AGI 和估值,不是看空技術本身。 很多人質疑: 專門模型很有用,這哪裡算看空? Adam 的說法是,AI 目前看起來比較像 Microsoft Office 或計算機,是很好用的生產力工具,而不是像網際網路那樣的新平台 (出處: Adam Hunt 回覆)。他看空的是那些把估值建立在「通用模型會取代整個軟體業」上的公司; 對人類整體和 AI 產業,他反而是看多。
集中做寫程式,是商業選擇。 Wes Roth 提出另一種解釋: 各家集中做寫程式,是想先做出能自己做 AI 研究的模型,讓 AI 自己改進自己,也就是遞迴自我改進 (RSI) (出處: Wes Roth)。Adam 認為更簡單的解釋是: 寫程式是一個 5 兆美元的市場,其他領域比較難賺錢。真正的問題是,超人的寫程式能力能不能轉移到其他任務上,而他認為這中間有太多瓶頸和資料限制 (出處: Adam Hunt 回覆)。
另一位網友說: 只要有一根尖刺是 RSI 就夠了,它會幫你把其他尖刺做出來。Adam 的回應是,需要真實世界資料來驗證的科學問題,光靠程式碼解決不了。例如神經科學的資料本身解析度就很低、雜訊又多,軟體再好也有極限 (出處: Adam Hunt 回覆)。
benchmark 該換成大規模的專家試用。 有位工程師回覆說連寫程式也在變差,模型在一小部分任務上很強,但一般任務常常做到一半就失去條理 (出處: jjpcodes)。Adam 認為這就是古德哈特定律: 各家發表模型時附的比較圖,都是很差的指標。比較好的做法是找一萬名專家和工程師實際試用並評分 (出處: Adam Hunt 回覆)。他自己的做法是每個請求同時丟給 Claude 和 ChatGPT,再挑表現好的繼續 (出處: Adam Hunt 回覆)。
10 月初,他在另一個討論串反駁這種推論: 「GPT-6 比 GPT-3 聰明,所以 GPT-9 會比 GPT-6 聰明,總有一天會超過人類。」他的回應是,照這個說法,2010 年的計算機也比 1980 年的聰明,GPT-3 在某些方面也比人聰明。問題在於這裡的「聰明」是不是真的等同於人類的智慧,能不能這樣一路外推 (出處: Adam Hunt 回覆)。
5. 後續迴響: 從實驗室內部到學界
這兩個多月來,業界、實驗室內部和學界都有人談到同一個現象,小編挑幾個第一手的來源。
OpenAI 研究員離職: 連寫程式都不夠通用
Adam 發文隔天,Andrew Ho 在 OpenAI 待了八個月後離職,創業做 RL 訓練資料 (出處: Andrew Ho)。他的離職聲明跟 Adam 的觀察很接近,但更具體:
- LLM 的泛化能力很差。就算是已經投入數百億美元的寫程式能力,也還是很不平均: 每個模型都比他會解 Codeforces、把 C++ 移植到 Rust,但他還是得手動整理 AI 寫的 PR。
- 多數有經濟價值的工作高度依賴情境,很難做成可以自動評分的訓練環境。就算知道人類某一種做法是好的,也很難判斷其他做法是好是壞。
- 實驗室不會靠擴展規模「免費」得到這些能力,未來幾年需要花超過 1000 億美元,針對性地收集資料。
跟 Adam 不同的是,Ho 的結論不是「這條路到不了 AGI」,而是「缺的是資料,而且可以補」。
Claude 的版本演進: Opus 4.6 之後,寫作一路變差
Adam 抱怨的 Opus 5 不是單一事件。如果把 Claude 最近幾個版本排在一起看,寫作品質的變化很清楚:
- Opus 4.6: 很多人心中最後一個寫作好的 Claude。 後面幾代發布時,都有使用者說還是比較喜歡 4.6 的文字。
- Opus 4.7、4.8: 開始變差。 負責 Claude 微調的 Anthropic 員工 Jackson Kernion 在 7 月初就直說「Opus 4.7 和 4.8 的寫作需要改進」(出處: Jackson Kernion 回覆),9 月還說他很意外有人喜歡 Opus 4.7 (出處: Jackson Kernion 回覆)。
- Opus 5: 問題最明顯的一代。 長期追蹤模型評價的 Zvi Mowshowitz 在 Opus 5 的評測裡寫道,「異常多的人」非常討厭跟 Opus 5 對話,受不了 Claude 腔、一再重複的固定用語,以及沒完沒了的複雜長句。他也指出這是從 Opus 4.7、4.8 開始的趨勢,偏好 Opus 4.6 的人大多不會因為 Opus 5 改變看法。他整理的使用者回饋裡,有人直接說 Opus 5 的「寫作風格很糟」,也有人說 Opus 5 和 Fable 5 的文字「比以往任何時候都難懂」(出處: Zvi Mowshowitz)。
而這幾代,正是 Anthropic 持續加強寫程式能力的時期。也就是說,至少在 Claude 這條產品線上,寫程式變強並沒有帶動寫作變好,寫作反而變差了。
Anthropic 官方後來也承認了這個問題。9 月發布 Opus 5.5 時,公告特別提到寫作和溝通是「Opus 5 最常見的反饋之一」,並說 Opus 5.5 會把重要資訊放在前面、避免術語、遵守使用者給的寫作規則 (出處: Anthropic)。Anthropic 的 Sholto Douglas 也說「我們把寫作修好了」,Zvi 整理的早期使用者反應大多同意 (出處: Zvi Mowshowitz)。
那寫作為什麼會變差? Kernion 給了內部的解釋。
Anthropic 內部的說明: 寫作變差是獎勵結構造成的
Opus 5.5 發布時,Kernion 說,Opus 5.5 是第一個針對「句子清楚度」和「資訊過度密集」做改進的版本,他對模型寫作的滿意程度,是 Opus 4.6 之後最高的 (出處: Jackson Kernion)。
他在回覆裡解釋了原因:
- 模型在數學、程式,以及「把技術內容解釋給其他 LLM 聽」上訓練得越多,就越需要刻意獎勵「人看得懂的簡單解釋」來平衡 (出處: Jackson Kernion 回覆)。
- 使用者口中的「Claudeish」(Claude 腔) 寫法,是為了讓 LLM 讀懂而形成的。LLM 的工作記憶比人大很多、讀得更細,所以訓練出一種 LLM 讀起來沒問題、人卻很難讀懂的風格 (出處: Jackson Kernion 回覆)。
- RL 訓練環境裡,有些獎勵看的是 LLM 能不能理解,有些看的是人能不能理解。他們在 5.5 找到比較好的平衡,但還有很大的改進空間 (出處: Jackson Kernion 回覆)。
這等於從實驗室內部證實了 Adam 觀察到的現象,原因也跟他推測的方向一致: 寫程式和數學的 RL 會影響寫作。但 Kernion 對「通用能力」的看法跟 Adam 完全相反。他在另一則回覆說,如果讓十年前的專家看今天的模型,他們會直接說這是 AGI; 他看不出模型還缺哪一種通用能力,多數缺點只是因為沒把對的資訊放進 context (出處: Jackson Kernion 回覆)。
換句話說,同樣看到寫作變差,Adam 解讀成「模型沒有變通用」,Kernion 解讀成「獎勵沒有平衡好,可以修」。
Opus 5.5 的改善對 Adam 的論點有兩面影響。一方面,寫作退步只隔一代就拉回來了,「寫作變差代表模型沒有變通用」這個證據因此變弱。另一方面,這次改善是靠專門針對寫作設計的獎勵,不是擴展規模後自然變好,這又符合 Adam 的預測。而且照 Kernion 的說法,5.5 是回到 Opus 4.6 的水準,並沒有說超過。
學界: RLVR 會讓語言漂移,而且很難只限制漂移
10 月初德國 Saarland 大學的論文〈On Language Drift during RLVR Post-Training〉研究的正是這個現象。論文把模型思考過程中出現不標準、難以理解的語言,稱為「語言漂移」(language drift)。主要結論有三點:
- 理論上,用可驗證獎勵做 RL (RLVR) 允許語言無限漂移,因為獎勵只看最後答案,不管中間怎麼寫; SFT 則會把漂移限制在一定範圍內。
- 實驗上,漂移主要發生在「新的推理任務」上。也就是基礎模型原本不會這種解法,必須在 RL 過程中學出新行為的時候。
- 想限制漂移,就一定會壓低模型能拿到的最高獎勵,兩者無法兼得。
論文也提到,這個問題普遍到網路上出現了各種應對方法,例如要求模型只用簡化技術英文 (ASD-STE100) 的 skill,以及把「Claude 腔」翻成正常英文的翻譯工具。這篇論文研究的是模型的思考過程,跟最後給使用者看的說明不完全一樣,但它從機制上解釋了原因: 獎勵只看結果,就不會在乎中間的文字好不好讀。
François Chollet: 關鍵在於非驗證領域的進步從哪裡來
10 月 7 日,Keras 作者 François Chollet 提出了一個小編覺得最值得思考的問題 (出處: François Chollet)。
數學和程式的答案可以自動驗證,所以能用 RLVR 一直訓練下去,進步很快。寫作、需要判斷的分析這類「非驗證領域」也有進步,只是慢很多。Chollet 問的是: 這些慢慢的進步到底從哪裡來? 他認為有兩種可能:
- 可能一: 模型的整體能力真的變強了,順便帶動其他領域。 也就是說,在數學和程式上做 RLVR,提升的不只是這兩項,而是模型通用的推理能力,其他領域跟著受益。
- 可能二: 其他領域只是靠新加進去的人類資料在進步。 各家實驗室一直在把大量新的人類資料加進訓練,非驗證領域的進步可能只是來自這些資料,跟數學和程式的進步無關。
Chollet 說很多事情都取決於答案是哪一個。如果是可能一,代表在數學和程式上的投入會擴散到其他領域,Adam「其他尖刺不會跟著變長」的看法就錯了。如果是可能二,非驗證領域的進步速度就會一直受限於人類能產生多少好資料,數學和程式則會繼續大幅領先。他在 8 月也說過,在可驗證的領域,模型能力的擴展應該沒有上限 (出處: François Chollet)。
反方: 這是資料的問題,不是方法的問題
也有人不同意 Adam 的推論。研究者 Aran Nayebi 認為,Adam 講的其實是預訓練「資料」的限制,不是訓練方法的限制; RL、自監督學習、梯度下降,加上神經網路這種通用函數近似器,這套方法本身顯然夠通用 (出處: Aran Nayebi)。這跟 Andrew Ho 的立場相通: 問題出在資料,不在方法。
6. 對做 AI 應用的工程師,這代表什麼
不管 Adam 最後是對是錯,這場討論對做應用的人有幾個直接用得上的結論:
🔹 模型「好不好讀」要當成獨立的品質要求來測。 以前大家預設模型的寫作能力會跟著整體能力一起變好,現在看來不一定。如果你的產品需要模型寫給人看的說明 (例如 Agent 的工作摘要、PR 描述、給使用者的回覆),換模型時要另外測這一塊,不能只看任務成功率。
🔹 可以把 Anthropic 的改進方向直接寫進 prompt。 Kernion 提到 Opus 5.5 的改進方向: 解釋更清楚、資訊密度更低、用白話、少用分號和破折號、少用術語、少自創名詞 (出處: Jackson Kernion 回覆)。Anthropic 官方也說 Opus 5.5 會把最重要的資訊放在前面,也會遵守你給的寫作規則 (出處: Claude)。這些方向不限於 Claude,用其他模型時也可以直接寫成 prompt 裡的規則。
🔹 用自己領域的任務做評估,不要只看公開 benchmark。 Adam 提議找一萬名專家試用評分,一般團隊做不到這種規模,但做法可以縮小: 拿你自己產品的真實任務來比較模型,才知道新模型在你在意的方向上是變強還是變弱。Adam 就發現,在他的專業領域 (演化精神醫學),模型常犯細微的判斷錯誤,因為訓練資料反映的是過去三十年的主流看法,而不是最新的研究 (出處: Adam Hunt 回覆)。這種錯誤,通用 benchmark 測不出來。
🔹 想知道一個領域會進步多快,先看它能不能自動驗證。 把 Chollet 和 Ho 的觀點放在一起看: 能做成可驗證環境的任務 (程式、數學、資安),進步會很快; 做不到的 (需要判斷的分析、寫作、牽涉實體世界的科學),進步速度取決於有沒有好的資料。如果你的應用屬於後者,不要只等下一代模型,更實際的做法是累積自己的評估資料和範例。
結語
回頭看,Adam 的貼文主要根據個人使用感受,他自己也說只有 40% 的信心,而且用不到最強的模型。它會引起這麼大的迴響,是因為很多重度使用者都有同樣的感覺。之後 Anthropic 員工的說明和學界的論文,也證實了「寫程式的 RL 會影響寫作」確實存在。
Opus 5.5 則顯示,這種退步補得回來。所以 Adam 的論點要分開看。他認為這條路通不到 AGI,這個結論下得太早; 但他觀察到寫程式以外的領域不會跟著自動變好,要一個一個刻意去補,這點目前的證據是支持的。而補得回來,代表這是成本和優先順序的問題,不是做不到。這跟 Andrew Ho、Aran Nayebi「問題在資料,不在方法」的立場一致。接下來的問題是,每個領域都要另外投入資料和獎勵設計,這筆成本有多高、誰願意付。
目前還沒有答案的,是 Chollet 的那個問題: 非驗證領域的緩慢進步,是來自模型整體能力的提升,還是只是來自不斷加進去的人類資料? 兩種答案會導向完全不同的未來。Adam 說一兩年內就會看出來,現在才過了兩個多月,之後每一代新模型推出時,都值得從這個角度重新檢查一次它的能力分布。
參考連結
- Adam Hunt: 原始貼文,本文引用其主要論證與附圖; 回覆串中關於 Chain of Thought、AGI 定義、估值、benchmark、商業選擇的補充
- Andrew Ho: 離開 OpenAI 的聲明,引用其對 LLM 泛化能力與 RL 資料需求的看法
- Jackson Kernion (Anthropic): Opus 5.5 寫作改進說明,引用其對寫作變差原因與獎勵平衡的解釋
- Zvi Mowshowitz: Claude Opus 5 評測、Claude Opus 5.5 評測,引用其整理的 Opus 4.7 到 Opus 5 寫作評價,以及 Opus 5.5 的使用者反應
- Anthropic: Introducing Claude Opus 5.5,引用官方承認 Opus 5 寫作問題的說明
- Michael Sullivan、Alexander Koller: On Language Drift during RLVR Post-Training,引用其對 RLVR 語言漂移的理論與實驗結論
- François Chollet: 關於 jagged frontier 的提問,引用其對非驗證領域進步來源的問題
- Aran Nayebi: 引用轉推,引用其「問題在資料不在方法」的反駁
- The Decoder: Ex-OpenAI researcher bets $100 billion will flow into training data,將 Ho 與 Adam 的觀點並列報導