Token 怎麼再便宜 1000 倍? 前 NVIDIA 工程師的答案: 放掉低延遲,專做背景 Agent 的推論
看了 Invest Like the Best 這集訪談 Ex-NVIDIA Engineer: Why AI Is About to Get 1000x Cheaper,蠻有料的一場。
來賓 Neil Movva (@neilmovva) 大學時就在 NVIDIA 做 GPU kernel,現在創辦 Sail Research。他稱自己的公司是「token 工廠」: 用 API 提供開源模型的推論服務,也提供讓 Agent 長時間執行的雲端虛擬機。公司只有一個目標: 做到業界最低的每 token 成本,而且要遠遠領先。
他的做法可以用一句話說完: 不追求低延遲。 從 kernel、晶片、資料中心一路到電力,每一層都在回答同一個問題: 如果使用者不在旁邊等,token 可以便宜到什麼程度? 主持人 Patrick O’Shaughnessy 形容這集像一堂 401 等級的課,但講得很好懂 (出處: Patrick O’Shaughnessy)。
小編今天剛整理過〈入門導讀: AI 晶片架構〉,這集剛好可以當成實戰篇: 晶片層面的取捨,放到一間推論公司的商業決策裡,會變成什麼樣子。
以下是重點整理:
1. 推論的下一個主戰場是背景 Agent,不是聊天
過去兩年,推論市場以「聊天」為主。Baseten、Fireworks、Together 這些推論服務商都在拚低延遲,Neil 認為主要是被 Cursor 這個大客戶帶往這個方向,而一年前這確實是對的選擇。
但大約半年前開始,需求變了。大家要的不只是快,而是能連續做好幾個小時的長任務。在這種情況下,每秒輸出 100 個 token 和每秒 10 個 token 差別不大,只要慢一點能換到明顯更低的成本,就划算。
主持人反問: 「我什麼都想要越快越好啊?」Neil 的回答是: 你在等的時候,當然該拿到最快的回應,但他想做的是讓你根本不用等。用他的話說,最好的延遲就是沒有延遲,早上醒來,工作已經在夜裡做完了。
他還指出,只要人在迴圈裡 (下 prompt、等回應、再下 prompt),人就是瓶頸。你不會每五分鐘去管一次同事,而是交代一個大任務,隔天甚至隔週再回來看。他認為人和 Agent 的合作也會變成這種節奏。
另一個推動 Sail 的因素是開源模型。越來越多客戶希望「擁有」自己用的模型: 權重在自己手上,想怎麼部署都可以,也不會被拿走。這讓開源模型的推論服務一直有穩定的市場。
2. 為什麼是現在: 模型撐得了長任務,需求也沒有上限
第一個理由是 test-time compute scaling,也就是給 Agent 越多時間思考和嘗試,結果就越好。這個概念大約兩年前就有人提出,但 Neil 認為要到 2025 年底的 Opus 4.5,才第一次有適合長任務的 Agent。現在的模型 (包括開源模型) 已經能穩定跑一個小時左右的任務,還做不到好幾天,但任務長度一直在增加。
第二個理由是需求。人在迴圈裡能用的 token 有上限: Neil 說如果要他在 Codex 或 Claude Code 上多用 10 倍 token,他大概做不到,因為他每天坐在電腦前的時間已經都花在跟 coding agent 來回互動了。背景執行就沒有這個限制,用多少 token 都可以。
他預測今年底背景工作和即時工作大約各佔一半,之後會變成背景 90%、即時 10%。
他也認為 token 不會一直是計價的單位。透過 Agent 使用模型時,你其實控制不了它要推理多久、呼叫幾次工具。他預期之後會更接近「按成果計算」: 交代 Agent 完成一件工作,它可以多試幾次,花多少 token 視任務而定。也就是 Agent 自己管理 token 預算,而不是公司規定每個工程師每月能花多少。
3. 背景 Agent 適合做什麼
🔹 Deep research: 不是查 100 個或 1,000 個來源,而是查一萬個以上,最後給出有根據的結論。例如 Sail 的客戶 Parallel Web Systems 想替整個網路建索引並即時追蹤變化,這需要非常大量的運算。
🔹 資安: 寫出一段程式碼的方法有限,能破解它的方法卻多得多。Fable、Mythos 推出時,資安圈開始用它們把既有程式碼從二十種角度檢查一遍 (記憶體錯誤、商業邏輯錯誤、網路漏洞⋯),而且不只讀原始碼,還會架起環境實際做滲透測試。圈內甚至開玩笑說「安全變成了工作量證明 (proof of work)」: 軟體有多安全,要看你花了多少錢讓最強的模型去攻擊它。
這裡有個小編覺得很實用的細節: 不同模型找到的 bug 不一樣。Fable 找到的 bug 並沒有涵蓋所有 bug,有些 bug 只有 Haiku 找得到,反過來也有。所以實務上會混用多種模型、多次取樣。這也是便宜的 token 在資安特別有用的原因: 找 bug 這件事,試得越多次、角度越多,結果就越好。
🔹 主動式的個人 Agent: Neil 最期待的是一個一直在背景執行的助理,讀過你每天收到的 email 和訊息,了解你的生活,在你打開手機時就猜到你下一步要做什麼,不需要你一直下 prompt。他認為技術上做得到,真正的門檻是成本: token 要便宜到可以「花了也不一定有回報」,這類產品才做得起來。
4. 要便宜多少: 一天用掉一兆 token
標題的「1000 倍」從這裡來。一兆個 token 照 OpenAI 的價格至少要 500 萬美元,而 Neil 想打造的,是一個人一天能用掉一兆 token 的世界。要做到這點,每 token 成本還要再降三到六個數量級。他也提到,對某些尺寸的模型,一兆 token 的成本已經接近幾萬美元,單一工作已經付得起。
他認為我們現在還把 Agent 當成「很貴的顧問」,遇到難題才去問,這不是使用 AI 的正確方式。他也常聽客戶說「我沒辦法給免費方案的使用者這麼多 token」,這正是他想解決的問題。
他特別強調「可驗證」的問題: 大部分軟體、數學證明,以及很多科學研究,都能檢查答案對不對。這類問題的成本其實就是「要投入多少 token 才解得出來」,而長任務的成本已經從百萬美元降到千美元等級,接下來可能是百元甚至十元。至於文筆、藝術這類沒辦法驗證的品味問題,他說公司不碰,留給人去做。
5. 延遲和吞吐量為什麼不能兼得
接下來是整集技術含量最高的部分。Neil 說 GPU 本質上是「吞吐量機器」: 工作量大到能讓所有運算單元滿載時,效率最好。聊天的使用方式剛好相反,要盡快把每個 token 送回給使用者,很難讓 GPU 滿載。
關鍵在 batching,也就是把很多使用者的請求合在一起算。合併得越多,GPU 利用率越高,但每個請求都要跟著整批一起走完每一步,單一請求花的時間就變長。他的比喻是公車和私人轎車: 轎車照你要的路線直接開到; 公車要載很多人,路線得兼顧大家,還要停站讓人上下車。
另一個例子是 tensor parallelism,也就是透過 NVLink (NVIDIA 的 GPU 之間高速互連) 把一個大的矩陣乘法拆給最多 8 張 GPU 一起算,以縮短單次運算的時間。但效益不是等比例的: 硬體用了 8 倍,速度大概只快 4 到 5 倍,因為 GPU 之間要互相傳資料,而且每張 GPU 只分到一小塊工作時,效率也會變差。
所以 Sail 不走這條路,偏好 expert parallelism (把 MoE 模型的不同專家放在不同 GPU) 或 pipeline parallelism (把模型的不同層放在不同 GPU),並讓 GPU 之間的資料傳輸和運算同時進行,把等待時間藏起來。這些做法在低延遲的服務裡比較難用。
- 小 batch,每個請求盡快送回
- tensor parallelism + NVLink 壓低延遲
- 硬體用 8 倍,速度只快 4 到 5 倍
- 需要高速晶片互連 (例如 NVLink)
- 大 batch,讓 GPU 滿載
- expert / pipeline parallelism
- 通訊和運算同時進行,藏住等待時間
- 互連較弱的晶片也能用
6. Sail 的做法: 沒有爛晶片,只有爛定價
從上一節可以推出: 要做低延遲推論,晶片之間需要很快的互連。Neil 認為 NVLink 在這方面幾乎是必要的,也是 NVIDIA 很強的地方,其他廠商要做出同樣好用、能大規模量產的互連並不容易。但如果不在乎延遲,其他廠商的晶片只要矩陣乘法算得快,就算晶片之間的互連比較弱,一樣可以用。
Neil 評估晶片主要看兩個數字: 能提供多少 FLOPS,以及每小時的持有和營運成本。有些晶片的「每美元 FLOPS」比 NVIDIA 還高,只是互連比較弱,他的工作就是找出適合這種晶片的平行化方式。這就是 Sail 的信條: 「沒有爛晶片,只有爛定價。只要價格對,任何晶片我都能讓它派上用場。」
會這樣想,也是因為最新的 NVIDIA 晶片很難買到。Neil 說 NVIDIA 不會單純漲價、讓出價最高的買家全部買走,因為他們知道算力就是影響力,會刻意分散給不同客戶。關係也很重要: 一間才成立幾個月的新創說要租一萬顆 Blackwell 三到五年,沒人知道它付不付得起,要拿到算力,需要很好的關係或很雄厚的資金。
他特別提到 AMD: 晶片本身很好,問題是很少人懂得怎麼把它的效能發揮出來。NVIDIA 自己的 kernel 已經寫得很好,能再優化的空間有限; 其他廠商在這方面投入較少,反而留下更多空間。外界覺得 AMD 比不上 NVIDIA,對他來說是好消息,可以趁大家不重視時多買。不過他也說,Meta 和 OpenAI 已經公開買了大量 AMD,AMD 的貨也越來越難拿到了。
除了 AMD,TPU、Trainium,還有 Etched、SambaNova、d-Matrix 這些新創的晶片,他都願意用。做法是異質的推論系統 (heterogeneous serving): 不同晶片混在一起用,各自負責擅長的部分。主持人說這本質上是套利,Neil 也同意。他認為 Sail 的優勢除了 kernel 團隊,還有願意很快為新晶片調整整套系統,而且沒有「現有機房只放得下某一種晶片」的包袱。
具體怎麼評估一顆晶片值多少錢、又怎麼把冷門晶片的效能調上來,Sail 有發部落格文章〈HTDYM (How To Deploy Your Model)〉和〈Chasing Speed of Light on TPU v6e〉說明,小編整理在文末的「延伸」。
7. Cerebras、Groq 這類晶片會變成搭配 GPU 的加速器
主持人問到 Cerebras、Groq 這種主打超低延遲的晶片。它們的做法是在晶片上放大量 SRAM,SRAM 跟運算單元在同一顆晶片上,讀取非常快,但很佔面積、容量小。GPU 則是在晶片旁邊放 HBM (堆疊起來的 DRAM),容量大但頻寬低得多。Neil 給了幾個數字 (更多背景可以看小編那篇晶片架構導讀):
- Blackwell 晶片上的 SRAM 大約只有 500 MB,旁邊的 HBM 有 288 GB,容量差了大約三個數量級
- 頻寬則反過來: Cerebras WSE-3 的 SRAM 頻寬是每秒 21 PB,Blackwell 的 HBM 大約每秒 10 TB
- 所以 Cerebras 用整片晶圓做成一顆晶片,再把多片串接起來,湊出 TB 級的高速記憶體,才能做到每秒上千個 token
但 Neil 認為這類晶片的弱點是 KV cache,也就是模型為對話中每個 token 存下的中間結果。模型權重的大小是固定的,可以事先放好; KV cache 卻會隨著使用者數量和對話長度一直變大,常常比權重本身還大,SRAM 的容量很難應付。
他預測的是混合架構。Transformer 裡有兩種性質不同的層: MLP 層 (模型大部分的知識存在這裡) 在 batch 夠大時,瓶頸在運算 (compute bound); attention 層在上下文很長時,瓶頸在記憶體 (memory bound)。他稱這是「Transformer 的原罪」: 兩種瓶頸完全不同的層緊緊接在一起,很難有一種晶片兩邊都擅長。比較合理的分工是 MLP 交給 Cerebras 這類晶片,attention 留在有大容量 HBM 的 GPU 上。他認為 NVIDIA 和 Groq 的合作就是往這個方向走。
他也坦言,推論公司完全受模型架構的設計影響。用 sparse attention 還是 dense attention、訓練精度從 BF16 降到 FP8 或 FP4,在模型開發商看來可能只是眾多設計選擇之一,卻直接決定他能用哪些晶片、硬體要怎麼配置。他對 OpenAI、Anthropic 沒有任何影響力,只能盡量預測它們的方向,提前準備。
8. 目前最沒效率的地方: KV cache 和閒置的 GPU
主持人請他排出整個系統最沒效率的地方,他分成兩個層次回答。
模型層面是 KV cache。 MoE 模型已經很稀疏了: 每次啟動超過 10% 專家的模型很少,前沿模型大概只啟動 1% 左右,這部分沒什麼浪費。但 KV cache 每個 token 要存好幾 KB,以實際包含的資訊量來看,大概多存了一到兩個數量級。DeepSeek 公開發表了不少壓縮 KV cache 的研究,大約每年都能再壓縮一個數量級,表示還有很大的改進空間。
他也順便解釋了為什麼對話很長時模型表現會變差: 模型訓練時看的大多是 8K 到 16K token 長度的資料,200K 雖然也訓練過,但不是它最擅長的長度。他自己用 Claude Code 時,也會在離 1M 上下文上限還很遠時就先 /compact。
全球層面是算力沒有被好好分配。 NVIDIA 今年要出貨大約 500 萬顆 Blackwell,他很懷疑這些晶片是不是一直都在工作。很多 GPU 被分配在私有的運算池裡,只給特定客戶用,常常閒置。大家常拿 xAI 叢集的利用率開玩笑,但他認為其他地方的情況其實更糟。
9. Kernel 工程會變成白板上的設計工作
Kernel 指的是在 GPU 上執行的程式。傳統上每個 kernel 只做一件事 (矩陣乘法一個、加法一個),後來越來越常把多個運算融合 (fuse) 成一個 kernel,省掉中間把結果寫回記憶體再讀出來的時間。像 FlashAttention 這類 kernel 是現代 Transformer 的基礎,但新模型只要跟常見做法有一點不同 (例如位置編碼 RoPE 的寫法變了),原本的 kernel 就得修改。
Neil 自己就是做 kernel 出身,但他的判斷很直接: 手寫 kernel 的時代要過去了。Sail 現在是「在白板上寫 kernel」: 團隊先在白板上討論 GPU 應該怎麼執行、工作怎麼分配,再用自然語言簡要地告訴模型,由模型寫出程式。他不認為 kernel 能力是 Sail 的護城河,前沿模型進步,所有人都會一起受惠,半年後的模型寫 kernel 會更好,各家模型開發商大概也已經大量自動化了。
不過軟體還是有很多事要做。大型矩陣乘法在 GPU 上已經能跑到峰值效能的 70% 到 80%,再往上會被功耗和散熱限制,不是軟體的問題。真正的問題是 Transformer 推論大部分時間不是在做這種大型矩陣乘法,所以他們要在晶片外圍建一整套系統,讓 GPU 隨時都有大批工作可做。而且現在已經不能只考慮一張 GPU: NVIDIA 的 GB300 NVL72 是 72 顆 GPU 組成一整個機櫃出貨,怎麼把整個機櫃當成一台電腦來寫程式,大家都還在摸索。
編按: 訪談前段 Neil 聊了一些 NVIDIA 往事。2015、2016 年,NVIDIA 的人在 ICML、NeurIPS 這些研討會上注意到,研究生都拿遊戲用的 GPU 訓練深度學習模型。Jensen 因此決定把更多晶片面積分給這個新用途,也就是第一代 Tensor Core (專門加速矩陣乘法的單元)。晶片面積在任何晶片公司都是嚴格把關的資源,放錯功能就是浪費,當時跟繪圖團隊爭取了很久,也只拿到大約 5% 到 10%。他也提到 NVIDIA 的「光速 (speed of light)」文化: 先算出每個硬體的理論上限,再想辦法把效能推到那個上限。他現在也這樣要求團隊: 只看離理論上限還有多遠,不看跟競爭對手比起來如何。
10. Sail 的做法: 用很多個只有 95% 可用率的小機房
這一節和下一節講的是 Sail 自己的經營策略,前提是客戶跑的是背景 Agent,可以接受偶爾變慢; 服務即時使用者的推論服務沒辦法這樣做。不過小編覺得這兩節最出乎意料,也最能說明「放掉低延遲」可以換到什麼。
Neil 說現在在美國要蓋 1 GW 的資料中心幾乎不可能,100 MW 也越來越難,10 MW 大概是勉強做得到的規模,1 MW 的地點則很多。有了液冷,1 MW 的運算設備大概只要 8 個機櫃。問題是這些電力很分散,對訓練沒有吸引力,因為訓練需要所有 GPU 集中在同一個地方。但推論不需要集中。
所以 Sail 的策略是蓋很多個 1 MW 的小機房,而且省掉大部分備援: 沒有備援電源、沒有柴油發電機、網路只拉一條光纖、不簽 SLA。他甚至預期有些機房的可用率只有 95%,這對一般資料中心是完全不能接受的數字,但他願意當第一個買家。
他接受得了,有兩個原因。第一,Sail 的調度系統夠可靠,只要各機房不是同時出問題,工作就能直接移到別的機房。第二,客戶跑的是好幾個小時的背景 Agent。GPU 突然斷線時,Agent 當下那一步要換到別的 GPU 重跑,可能多花幾分鐘,甚至十分鐘,但客戶在睡覺,根本不在意。
所以他直接跟客戶說: 平均吞吐量會很有競爭力,但 p99 延遲 (最慢那 1% 請求的延遲) 沒辦法保證,換來的是其他人給不了的價格。
11. Sail 的做法: 晶片和電力都用別人不要的 (拾荒策略)
同樣的想法也用在電力上。他認為美國的太陽能和風力發電被低估了,過去不適合資料中心,是因為發電量不穩定。但對 Sail 來說,就算某個機房因為沒風或起霧停擺好幾天、甚至好幾週,也是可以預測的: 用天氣模型預估哪裡會停電,事先把工作移走就好。只要晶片夠便宜,晶片閒置一陣子的成本他也能接受。
主持人把這整套做法稱為「拾荒策略 (scavenger strategy)」,Neil 也同意: 先撿別人不要的晶片,再撿別人不要的電力。他不打算跟 Anthropic、OpenAI 搶大規模、集中的算力,因為搶不贏; 他要的是大廠看不上或嫌麻煩的供給,一點一點累積成總量很大、但分散各地的產能。他的比喻是: 一樣要做最好的鋼鐵廠,但靠的是很多座小型鋼廠 (mini mill),而不是一座大型鋼鐵廠。
主持人追問要做到多垂直整合: 從電力、資料中心、自研晶片到軟體全部自己做,還是什麼都不擁有、只負責調度? Neil 說,身為創辦人他什麼都想做,但身為執行長得務實: 全部自己擁有需要的資金太龐大,而軟體投入少、效益高,所以先從軟體做起。電力方面,先跟電力公司簽長期購電合約,讓專業的人做專業的事,等規模夠大再考慮自己做。他的出發點是: 上游供應商都按照既有客戶的需求在設計產品,而推論會是史上最大的算力市場,值得為它重新設計很多東西。合作夥伴做不到的,他就自己做。
編按: Sail 實際的價格有多便宜? 小編查了 2026/10/11 的牌價。Sail 主打的就是訪談裡講的「願意等就便宜」: 同一個模型分成三種方案,預設的 ASAP 沒有空閒算力就直接回錯誤,不排隊; Balanced 會排隊等算力; Flex 只接受背景請求或 Batch,官方文件說尖峰時段可能要等很久。
這種方案不是 Sail 獨有,OpenAI、Gemini 都有 Flex,各家也都有 Batch API,多半是自家標準價打五折。但專門跑開源模型的供應商 (Together、Fireworks) 在便宜方案上通常只提供 Batch,要上傳檔案、最慢 24 小時才拿到結果。像 Sail 這樣分成 ASAP、Balanced、Flex 三種方案的,在開源模型供應商裡比較少見。
有些模型的 Flex 甚至比別家的 Batch 還便宜。Kimi K3 的 Flex 每百萬輸出 token $6.25,是 OpenRouter 上所有供應商裡最便宜的,OpenRouter 上 Kimi K3 的 batch 是 $11.4,Moonshot 原廠是 $15。GLM-5.3 的 Flex 是 $1.80,Z.AI 原廠和 Together、Fireworks 都是 $4.40。
整體來看,便宜確實來自「願意排隊、不保證延遲」,跟訪談的說法一致。目前 Flex 跟原廠比大約便宜一半多,離標題的 1000 倍還很遠,那是長期目標 (出處: Sail Pricing、Sail Completion Windows、OpenRouter、OpenAI Flex、Gemini Flex、Together Batch API)。
12. 他在晶片上的幾個非共識觀點
主持人問他有哪些想法會讓朋友覺得很奇怪,他舉了幾個:
🔹 把 KV cache 放到 flash,避開 HBM 短缺: 他一直在團隊裡推動調整模型架構,讓 KV cache 能大量移到 flash 這類便宜的儲存裝置。這在推論圈是少數派的想法,但如果系統只需要每秒 1 到 10 個 token,能做的設計就完全不一樣。他也認為 HBM 短缺會持續一陣子,因為記憶體廠被景氣循環傷過很多次,不太願意大幅擴產,結果是很多東西都會變貴,例如 iPhone 可能會減少記憶體或漲價。
🔹 每瓦效能其實沒進步那麼多: 同樣比較 BF16 乘法的每瓦效能,從 Hopper、Blackwell 到 Rubin,進步沒有大家以為的那麼大; TSMC 從 5 奈米到 2 奈米也是如此。所以他認為就算失去 TSMC,影響也沒有想像中嚴重: 供給會受到衝擊,但 Intel 等西方最好的製程,每瓦效能頂多差 2 倍左右。
🔹 晶圓廠可以讓客戶參與更多取捨: TSMC 花很多功夫讓同一批晶片的品質盡量一致 (縮小 process corner 的差距),讓最差的晶片跟最好的晶片差不多。但這些製程控制要花時間和成本。Neil 說他可能願意接受更多品質較差的晶片,只要有便宜的電力和空間可以放它們。
🔹 給晶片新創的建議: 先證明你懂限制晶片供給的四個瓶頸: TSMC 晶圓產能、HBM 產能、先進封裝、電力。NVIDIA 並不完美,只是各方面都很平衡,新創應該找一個 NVIDIA 很難改變的設計選擇,在另一個方向做出明顯差異。他認為 HBM 短缺是最值得切入的點。
🔹 NVIDIA 為什麼不自己賣 token: 因為 Jensen 很擅長讓客戶賺大錢 (例如 CoreWeave)。他要的是一群互相競爭、一起替 NVIDIA 創造需求的 neocloud 和推論服務商,任何一家想自己做晶片或改用 AMD,馬上有其他家補上。
13. 為什麼這次不是網路泡沫
主持人提到投資人的擔憂: 半導體在 S&P 500 市值的佔比,歷史上大約是 2% 到 4%,現在到了 20% 左右,看起來很像那些漲到高點後又跌回來的歷史案例。
Neil 生於 1997 年,母親在 2000 年網路泡沫時在 Intel 工作,他常拿那段歷史來對照。他的看法是: 當年的網路設備投資很多是押在預期中的未來需求,結果需求沒有出現; 2023、2024 年 Hopper 世代的晶片短缺,主要也是為了訓練,而訓練本身同樣是對未來的投資。但現在主要是推論,token 買了就馬上用掉,沒有人會囤 token,公司甚至要限制員工在 Claude Code 上能花多少錢。所以他認為推論的支出只會一路增加。
14. 開源與閉源: 前沿模型開發商付很高的代價,換 3 到 6 個月的領先
Neil 認為前沿模型開發商花非常多錢,換來比其他人領先 3 到 6 個月,目前看來還值得。但他不確定這個優勢能維持多久,因為企業換模型的速度根本跟不上: 很多企業可能還在用 Opus 4.6 或 4.7。
他對蒸餾 (distillation) 的看法蠻有意思。就算沒有人刻意去抓 Anthropic 模型的輸出,網路上的 AI 產生內容也越來越多。光看 GitHub,過去一年新建的 repo 有多少是 Claude Code 寫的? 他甚至覺得,只用 GitHub 上品質好的開源程式碼,可能就能訓練出 Fable 等級的模型。只要使用者擁有自己跟 AI 互動的產出、又選擇公開,這種「間接的蒸餾」就會一直存在。模型能力一定會擴散出去,差別只在快慢。
他期待的未來是「便宜的 token,加上多元的 harness」: 每家公司、甚至每個使用者都打造自己的 harness,客製化主要靠 in-context learning,而不是微調權重。
15. Transformer 和資料: 網路資料已經用完,下一步是 RL 環境
主持人也請他聊聊 Transformer。Neil 認為 Transformer 最大的優點是容易擴展: 它對資料沒有預設的假設,只假設序列中存在規律,然後用越來越多參數去找出來。電腦視覺時代最大的模型大約 1.5 億參數,現在動不動就上兆,Transformer 是關鍵。attention 讓任意兩個 token 之間都能建立關聯,也許不是每一對都需要,但在找到更好的篩選方式之前,它仍是很好的做法。他也引用 Karpathy 的說法: 拿到新資料集時,先用很多參數讓模型過擬合,證明它學得起來,再壓縮成更小的模型,壓縮的過程才帶來泛化能力。
資料方面,他引用一個說法: 網際網路是一次性的資料紅利。高品質文字大約 30 兆 token,放寬標準大約 300 兆,模型都已經看過很多遍了。以前很重視的使用者回饋 (例如 ChatGPT 上的讚和倒讚) 也不太有用了,因為現在的模型已經比一般使用者強,一般人的偏好沒什麼參考價值,需要的是專家的判斷。
他認為下一階段的資料來源是 RL 環境: 給模型一個困難、答案可驗證的任務,讓它在隔離的環境裡做,並能量測有沒有進展。程式和數學都屬於這類,接下來是直接給 Agent 一台電腦,讓它像真人員工一樣工作,並告訴它離目標還有多遠。用他的話說,環境本身就是資料。他甚至認為,通往 AGI 的方式就是一個領域接一個領域地補上專門能力,直到沒有缺口,唯一的條件是任務必須可驗證、能自動評分。他也觀察到,前沿模型開發商的支出已經從買資料轉向建 RL 環境。
小結: 延遲是可以拿來換成本的條件
整集聽下來,小編覺得最有收穫的是 Neil 把「延遲」當成可以拿來交換的條件。大部分人談推論成本,想的是更好的晶片、更好的 kernel; 他反過來問: 如果使用者根本不在旁邊等,哪些原本以為必要的東西可以拿掉? 答案從平行化方式、晶片選擇、機房備援一路到電力穩定性,每一層都因為「不保證延遲」而多出降低成本的空間。
對做 AI 應用的工程師來說,這也是很實際的設計問題: 你的工作裡,有多少其實不需要即時回應? 各家的 Batch API 就是用延遲換折扣的現成例子。當 Agent 有越來越多工作在背景執行,「這個任務能不能接受慢一點、偶爾失敗重跑」應該是設計架構時先回答的問題,因為它直接決定你能用多便宜的 token。
延伸: Sail 怎麼替晶片定價,以及把 Gemma 4 搬到 TPU 的實戰
訪談裡的「沒有爛晶片,只有爛定價」,Sail 在部落格〈HTDYM (How To Deploy Your Model)〉說明了實際怎麼做,還把內部的效能建模工具開源了 (程式碼在 GitHub,也有線上版可以直接試)。
為什麼要做這件事? 因為沒有一顆晶片在所有情況下都最划算。一顆晶片划不划算,取決於「跑哪個模型、做哪種工作、怎麼切分」這三者的組合:
- 模型: MoE 或 dense、用什麼精度、attention 怎麼設計,都會改變瓶頸在哪
- 工作類型: 處理輸入的 prefill 階段受限於運算,逐字產生輸出的 decode 階段通常受限於記憶體頻寬。記憶體頻寬相對算力高的晶片,可能很適合 decode、但做 prefill 普通。如果把兩個階段拆開部署 (disaggregated serving),就可以各自放在最適合的晶片上
- 切分方式: 大模型的權重常常一顆晶片的記憶體放不下 (例如 TPU v6e 只有 32 GB HBM,31B 的 Gemma 4 就要分給 4 顆一起跑),必須把模型拆開,分到多顆晶片上。拆法有好幾種: 把每個矩陣切開、每顆晶片各算一部分 (tensor parallelism); 把不同層分給不同晶片 (pipeline parallelism); 把 MoE 的不同專家分給不同晶片 (expert parallelism); 或是複製好幾份、各自處理不同請求 (data parallelism),實務上常混合使用。不同拆法下,晶片之間要傳的資料量不同,每顆晶片剩下多少記憶體放 KV cache 也不同,連帶影響 batch 能開多大。所以就算模型和晶片都固定了,換一種拆法,每美元能產出的 token 數就可以差 3 倍以上。Sail 說這是最常被低估的一點
但市場上的租用價格,主要反映的是晶片的整體名氣和供需,例如 NVIDIA 很搶手所以貴,冷門晶片少人用所以便宜,不會針對每個模型的實際表現定價。Sail 的說法是: 一顆晶片不需要對某個工作是最理想的,只要它的價格比它在這個工作上的表現便宜,就值得用。所以他們要知道的是,對自己服務的每一個模型,市面上每一顆晶片各值多少錢。實際表現和市場價格之間的落差,就是 Sail 壓低 token 成本的空間,而且這個落差會隨著晶片價格和工作負載一直變動,需要能快速重算。
怎麼算? 他們不只靠 benchmark,因為還沒拿到的硬體測不了、組合太多測不完,而且 benchmark 量到的有很大一部分是推論引擎成不成熟,冷門硬體尤其容易被低估。HTDYM 改用 roofline 從硬體規格估出效能上限: 把模型拆成一個個運算,估算運算、記憶體讀取、晶片間通訊各要多久,再窮舉所有切分和擺放方式,依「每美元 token 數」排名。
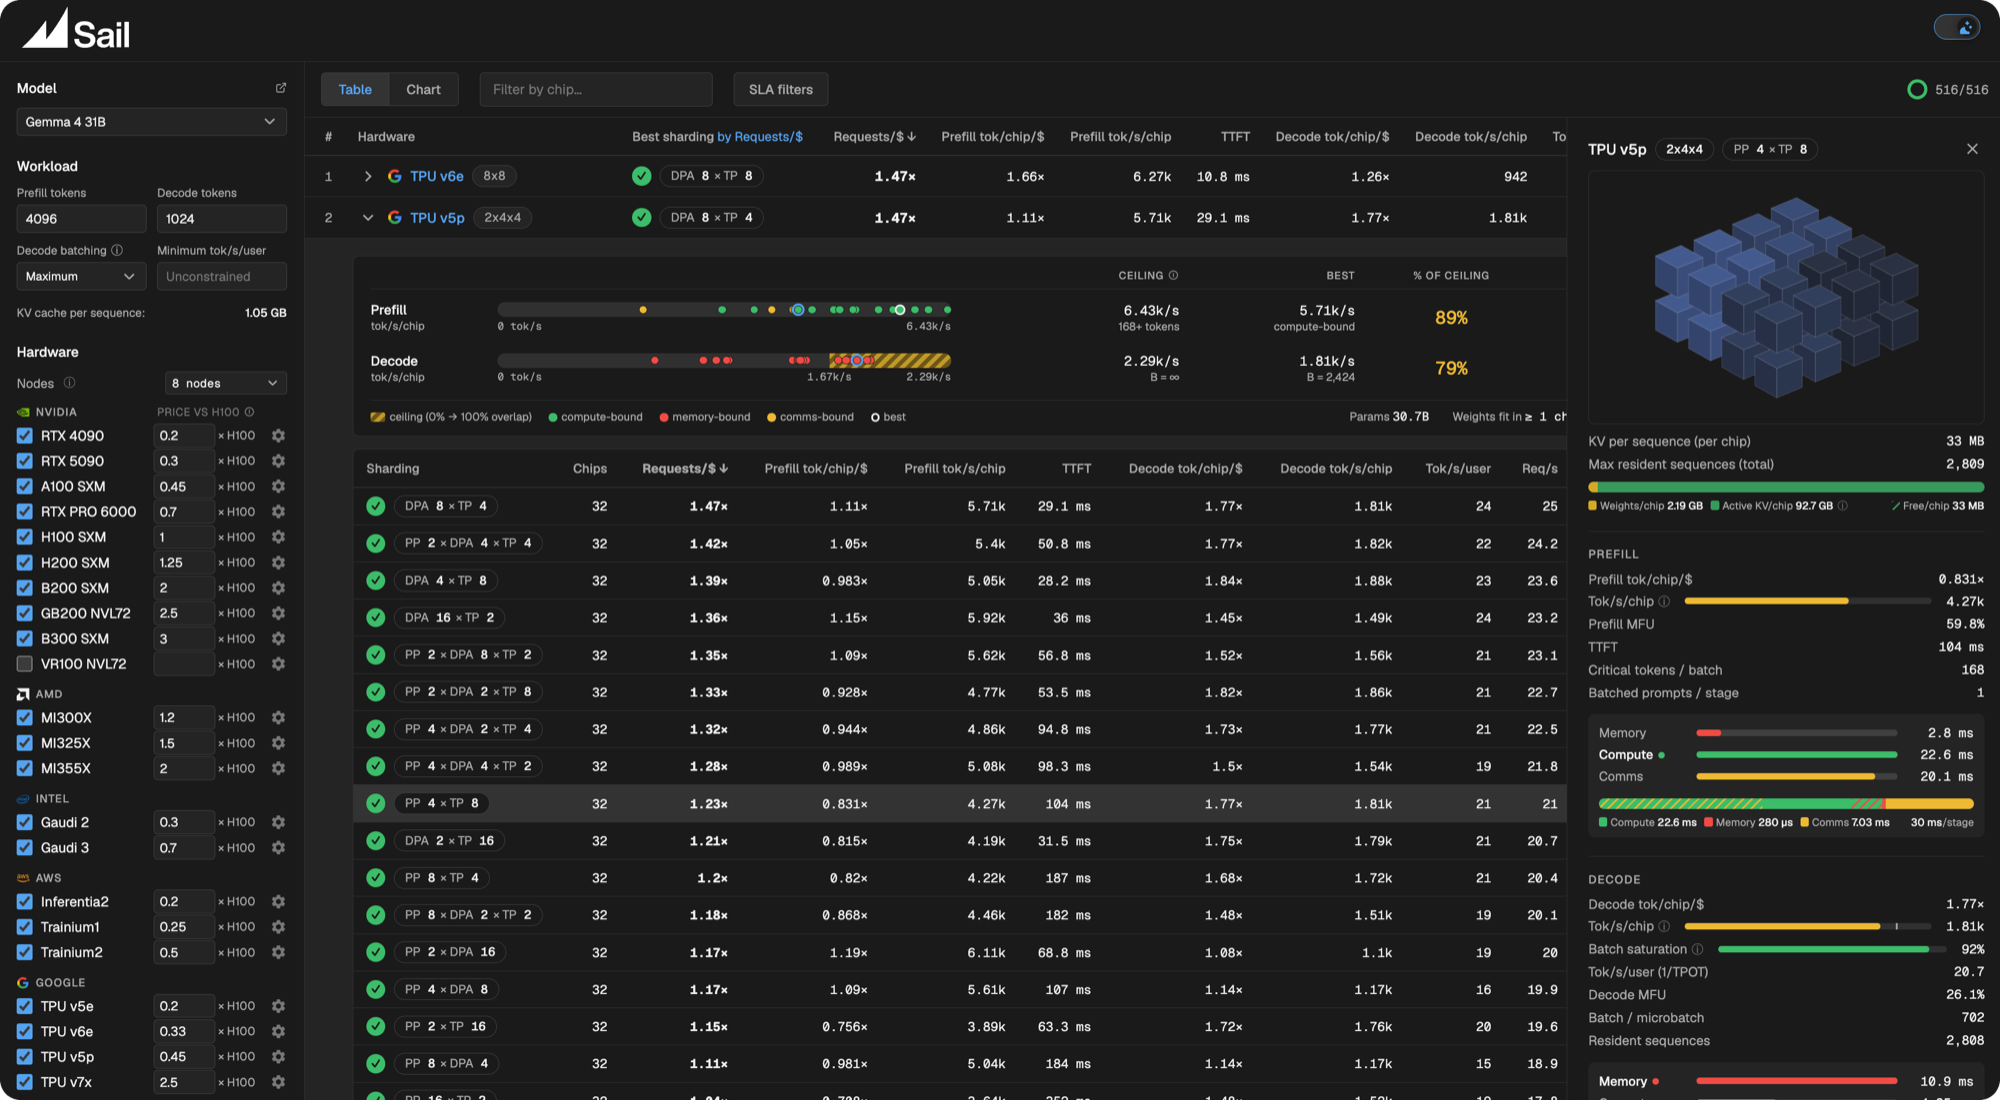
HTDYM 的介面: 左側設定模型、工作負載,以及每種晶片相對 H100 的租用價格,中間依每美元效能排出各種晶片和切分方式,右側拆解 prefill、decode 的運算、記憶體、通訊時間 (圖片來源: Sail Research)。
實際案例是 Gemma 4 31B。他們在 24 種晶片、3,455 種配置上評估,發現改用 Google 的 TPU v6e,跟目前用的 H200 比,輸入 token 成本可以降到大約三分之一,輸出 token 成本只增加約 25%,剛好適合他們以輸入為主的工作負載。TPU v6e 的算力跟 H100 相當,但 HBM 容量和記憶體頻寬都少很多,所以每美元的算力很高。
後續那篇〈Chasing Speed of Light on TPU v6e〉記錄了實際的調校過程。用現成的 SGLang-JAX 只有 32% 的 MFU (實際花的時間中,有多少比例在做模型必要的運算),經過調整 attention kernel 的參數、讓晶片間的通訊和運算同時進行、自己用 Pallas 寫 kernel 等優化後提高到 63%,每個輸入 token 的成本再減半,也略高於 SGLang 在 H100 上的開箱表現。
作者整理的方法蠻值得參考: 先從基本原理算出一個運算應該花多少時間,再實際量測,兩者有落差就先當成 bug 去查,直到證明是物理限制為止。這正是訪談裡講的「光速」文化的實際做法,也說明了 Sail 選用冷門晶片時,要額外付出哪些調校工作。